หนังสือราชการเป็นเอกสารที่ดูเหมือนอัตโนมัติง่ายที่สุดในองค์กร มันมีโครงที่กำหนดไว้ตามระเบียบงานสารบรรณ — เลขที่หนังสือ ส่วนราชการเจ้าของเรื่อง วันที่ เรื่อง เรียน อ้างถึง สิ่งที่ส่งมาด้วย เนื้อความ แล้วปิดท้ายด้วยลงชื่อและตำแหน่ง ทุกฉบับมีองค์ประกอบชุดเดียวกัน เรียงลำดับเหมือนกัน
ความเหมือนนั้นเองที่ทำให้หลายองค์กรประเมินงานนี้ต่ำไป แล้วซื้อระบบ OCR แบบเทมเพลตมาใช้ ก่อนจะพบว่ามันอ่านหนังสือจากกรมหนึ่งได้ และอ่านของอีกกรมไม่ได้เลย
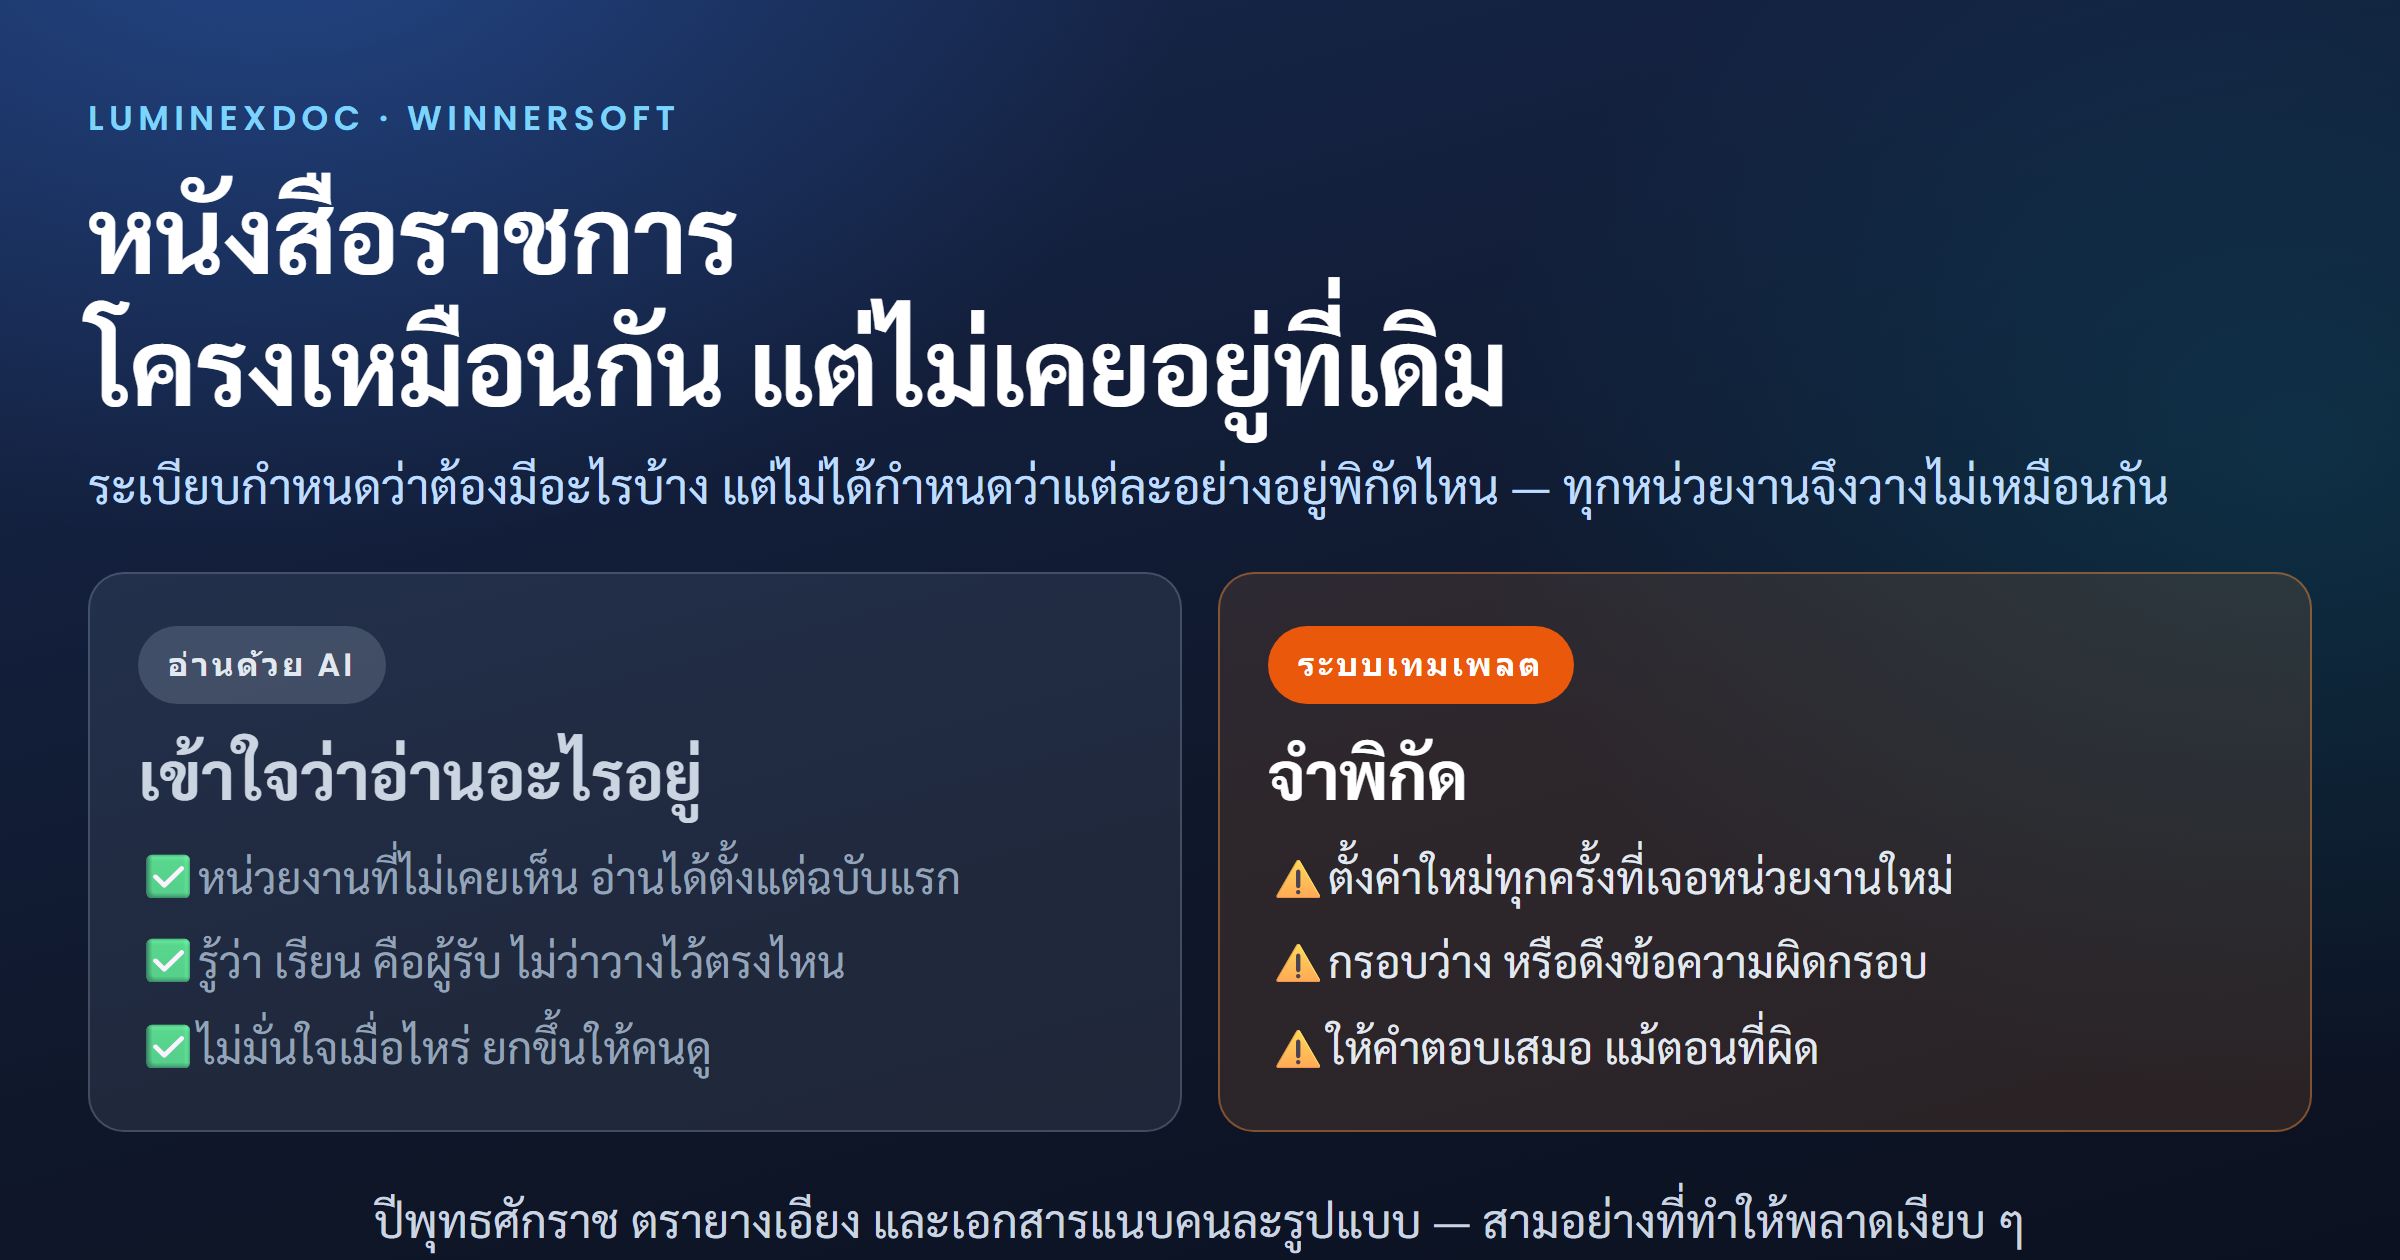
โครงเหมือนกัน แต่ตำแหน่งไม่เคยเหมือนกัน
ระเบียบกำหนดว่าหนังสือราชการต้องมีอะไรบ้าง แต่ไม่ได้กำหนดว่าแต่ละอย่างต้องอยู่พิกัดไหนบนหน้ากระดาษ ผลคือหน่วยงานแต่ละแห่ง — และบางครั้งแต่ละกองภายในหน่วยงานเดียวกัน — วางตำแหน่งต่างกัน ความกว้างของบล็อกหัวเรื่องต่างกัน ระยะขอบต่างกัน บางแห่งใส่ตราครุฑใหญ่ บางแห่งใส่โลโก้หน่วยงานเพิ่ม
ระบบเทมเพลตทำงานด้วยการจำพิกัด คุณบอกมันว่า "เลขที่หนังสืออยู่ในกรอบนี้" พอเอกสารฉบับถัดไปมาจากหน่วยงานอื่น กรอบนั้นก็ว่างเปล่า หรือแย่กว่านั้นคือมีข้อความอื่นอยู่ในกรอบ แล้วระบบก็ดึงข้อความผิดออกมาโดยไม่มีอะไรบอกว่าผิด
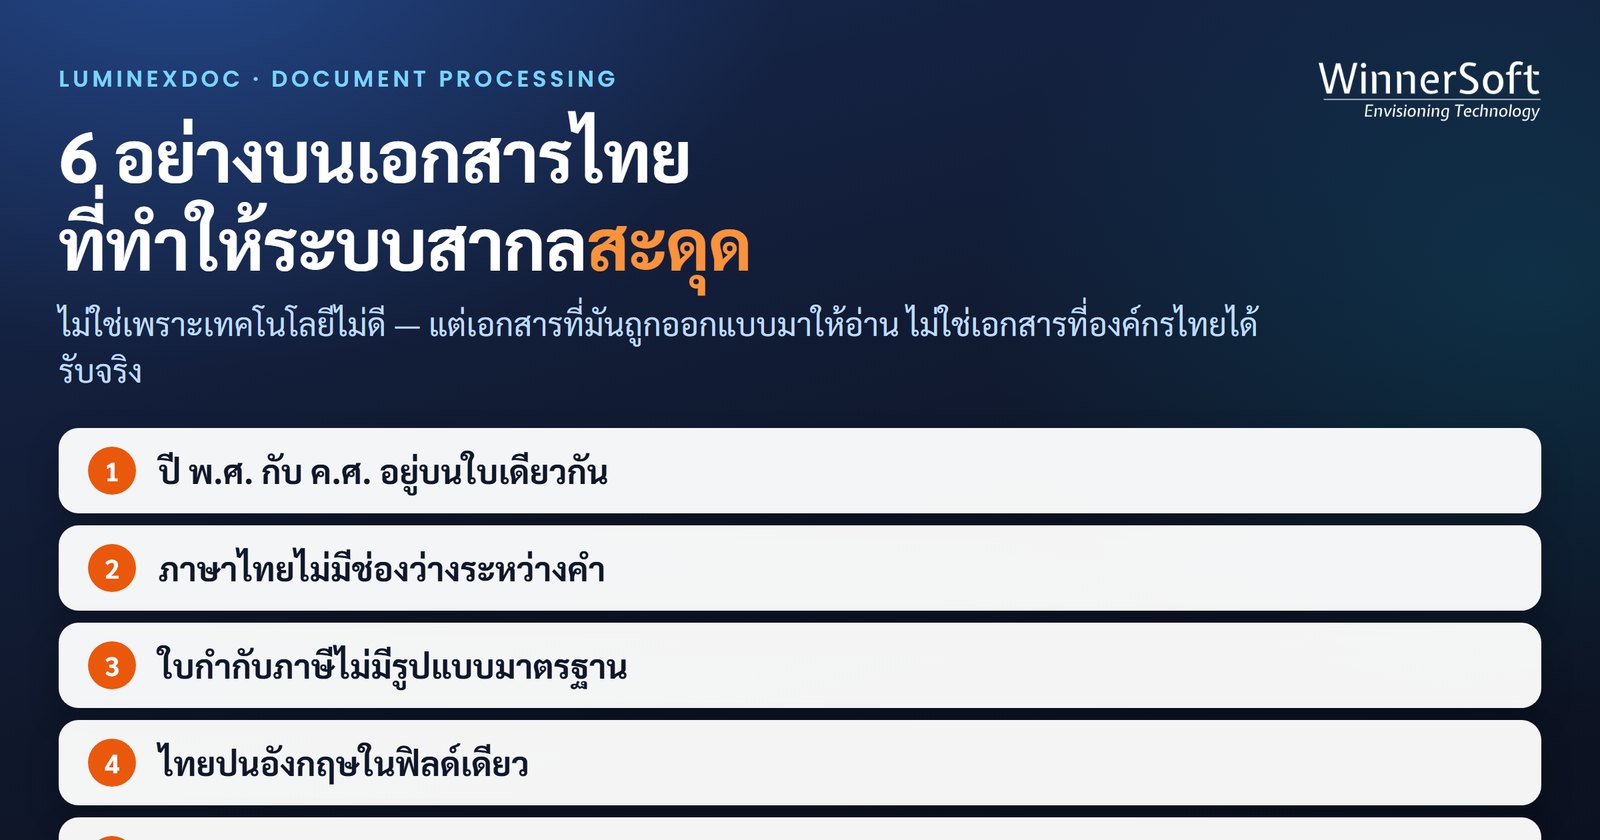
หกอย่างที่ทำให้เอกสารราชการไทยยากกว่าใบแจ้งหนี้
- เลขที่หนังสือไม่มีรูปแบบกลาง — แต่ละหน่วยงานมีรหัสของตัวเอง ยาวไม่เท่ากัน มีทั้งตัวอักษร ตัวเลข จุด ทับ และคำว่า ว นำหน้าเลขในหนังสือเวียน
- วันที่เป็นพุทธศักราช และเขียนเต็มเป็นตัวหนังสือ ไม่ใช่ตัวเลขล้วน ระบบที่คาดหวังรูปแบบ ค.ศ. จะอ่านปีผิดไป 543 ปีโดยไม่ฟ้องอะไร
- เรื่อง เรียน อ้างถึง สิ่งที่ส่งมาด้วย — สี่ฟิลด์นี้ยาวไม่เท่ากันทุกฉบับ บางฉบับ อ้างถึง มีหลายรายการ บางฉบับไม่มีเลย ทำให้ทุกอย่างที่อยู่ข้างล่างเลื่อนตำแหน่ง
- ตราครุฑ ลายเซ็น และตรายางรับเข้า ทับซ้อนกับข้อความบ่อยครั้ง โดยเฉพาะตรายางที่ประทับทีหลังและเอียง
- เอกสารแนบมักมีหลายหน้าและเป็นคนละรูปแบบกับหนังสือนำ เช่น ตาราง แบบฟอร์ม หรือสำเนาที่สแกนซ้ำจนจาง
- ภาษาราชการใช้ประโยคซ้อนยาว และคำสำคัญอย่าง จึงเรียนมาเพื่อโปรดพิจารณา หรือ โปรดดำเนินการภายใน มักอยู่ท้ายย่อหน้า ไม่ใช่ต้นประโยค
จุดที่เสียหายจริงไม่ใช่ตอนอ่านผิด แต่ตอนไม่มีใครรู้ว่าอ่านผิด
ระบบที่อ่านเลขที่หนังสือผิดหนึ่งตัวยังพอแก้ได้ถ้ามีใครเห็น ปัญหาคือระบบเทมเพลตส่วนใหญ่ให้คำตอบเสมอ มันไม่มีสถานะ ไม่แน่ใจ ผลลัพธ์ที่ผิดจึงไหลเข้าระบบสารบรรณต่อไปเหมือนผลลัพธ์ที่ถูก และไปโผล่อีกทีตอนตามเรื่องไม่เจอ
นี่คือเหตุผลที่เวลาประเมินระบบอ่านเอกสาร คำถามที่ให้ข้อมูลมากที่สุดไม่ใช่ อ่านแม่นกี่เปอร์เซ็นต์ แต่คือ ตอนระบบไม่มั่นใจ มันทำอะไร
AI อ่านต่างจากเทมเพลตอย่างไร
ระบบที่ใช้โมเดลภาษาไม่ได้จำพิกัด แต่เข้าใจว่าสิ่งที่กำลังอ่านคือหนังสือราชการ และในหนังสือราชการ เลขที่หนังสือคือสิ่งที่อยู่ต้นฉบับใกล้ชื่อส่วนราชการ ส่วน เรียน คือผู้รับ ไม่ว่ามันจะถูกวางไว้ตรงไหนของหน้า เอกสารจากหน่วยงานที่ไม่เคยเห็นมาก่อนจึงอ่านได้ตั้งแต่ฉบับแรก โดยไม่ต้องสร้างเทมเพลตใหม่
ใน LuminexDoc ทุกฟิลด์ถูกอ่านด้วย AI สามตัวแยกกันโดยไม่เห็นคำตอบของกันและกัน ตรงกันทั้งสามก็ผ่านไป ไม่ตรงกันเมื่อไหร่ฟิลด์นั้นถูกยกขึ้นมาให้คนดู คนจึงไม่ต้องตรวจทุกฉบับ แต่ตรวจเฉพาะจุดที่ระบบบอกเองว่าไม่มั่นใจ
ห้าคำถามที่ควรถามผู้ขาย ก่อนเริ่มโครงการเอกสารราชการ
- เอกสารจากหน่วยงานที่ระบบไม่เคยเห็นมาก่อน ต้องตั้งค่าอะไรเพิ่มไหม และใช้เวลานานแค่ไหน
- ปีพุทธศักราชถูกแปลงเป็นอะไรก่อนส่งเข้าระบบปลายทาง และใครเป็นคนกำหนดกฎการแปลง
- ตอนระบบไม่มั่นใจในฟิลด์หนึ่ง มันหยุด ถามคน หรือเดาแล้วส่งต่อ
- เอกสารแนบหลายหน้าที่คนละรูปแบบกับหนังสือนำ ระบบแยกออกหรือไม่ว่าอันไหนคือหนังสือนำ
- ถ้าอ่านผิดแล้วข้อมูลไหลเข้าระบบสารบรรณไปแล้ว มีร่องรอยให้ตามย้อนกลับไปถึงภาพต้นฉบับไหม
เริ่มจากตรงไหนดี
ไม่ต้องเริ่มจากทั้งระบบสารบรรณ เลือกหนังสือชนิดเดียวที่เข้ามามากที่สุดก่อน — ในหลายองค์กรคือหนังสือเวียนหรือหนังสือขออนุมัติ — แล้ววัดสองอย่าง เวลาที่คนใช้ต่อฉบับในวันนี้ และจำนวนฉบับต่อเดือน สองตัวนี้บอกได้ว่าคุ้มหรือไม่ ก่อนจะลงทุนกับอะไรก็ตาม
ถ้าอยากทดสอบกับเอกสารจริงขององค์กรคุณ เราเริ่มด้วยชุดตัวอย่างและวัดผลบนเอกสารของคุณเองก่อนเสมอ ไม่ใช่บนเอกสารสาธิต