ลองนึกภาพทีม IT ทีมหนึ่ง เห็นโพสต์ในกลุ่มนักพัฒนาว่ามีคนทดสอบโมเดล OCR ภาษาไทยที่รันในเครื่องได้สิบกว่าตัว บนการ์ดจอ 12 GB ตัวที่ดีที่สุดอ่านข้อความไทยได้เกือบเต็มร้อย
ฟรี ข้อมูลไม่ออกนอกบริษัท และดูเหมือนจะพอแทนการคีย์เอกสารได้ทั้งแผนก
หลายทีมกำลังอยู่ตรงจุดนี้ — และส่วนใหญ่ยังไม่รู้ว่าเส้นทางจากเดโมวันแรก ถึงระบบที่ฝ่ายบัญชีใช้งานได้จริง มีอะไรรออยู่บ้าง บทความนี้เล่าทางนั้นให้ดูทีละด่าน
วันแรก: ว้าว
ติดตั้งโมเดลอย่าง Typhoon OCR, dots.mocr หรือ PaddleOCR ใช้เวลาไม่ถึงวัน โยนใบกำกับภาษีเข้าไปหนึ่งใบ ข้อความไทยออกมาครบ สะกดถูก ตารางก็ดูเป็นตาราง
ทุกคนในห้องคิดเหมือนกัน — งานนี้ง่ายกว่าที่คิด
ซึ่งถูกครึ่งเดียว การอ่านคือส่วนที่ง่ายที่สุดของงานนี้ และเป็นส่วนเดียวที่ OCR ทำ
สัปดาห์แรก: ได้ข้อความ แต่ระบบบัญชีอยากได้ข้อมูล
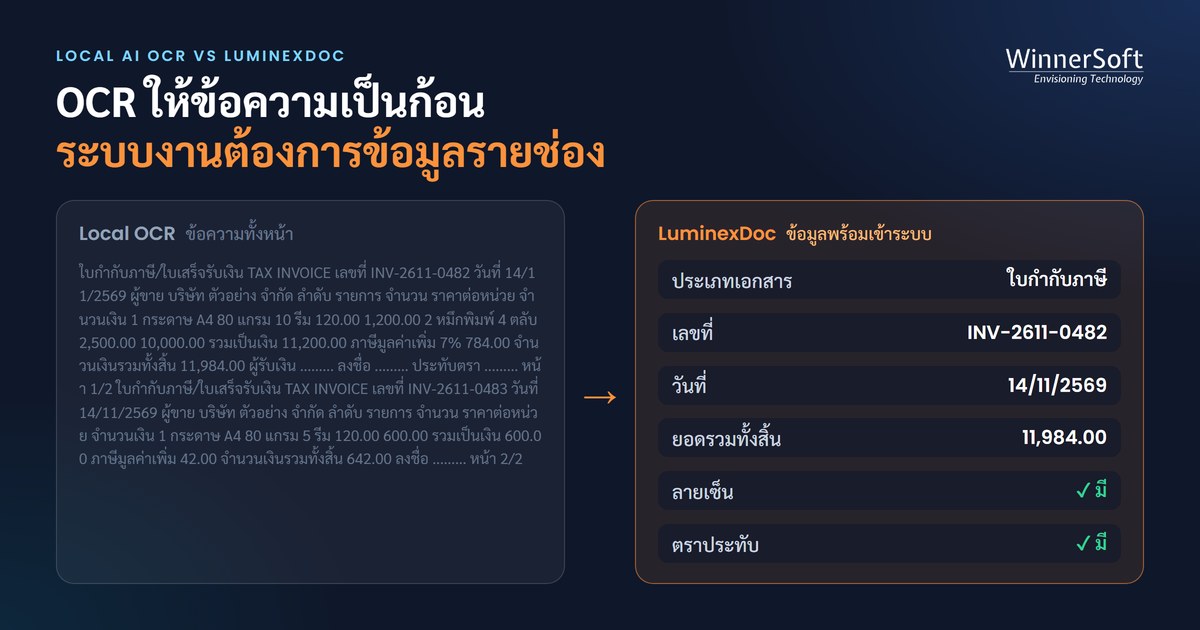
ปัญหาแรกโผล่มาตอนจะส่งผลเข้าระบบ สิ่งที่โมเดลให้มาคือข้อความทั้งหน้า บางตัวจัดเป็น Markdown สวยงาม แต่ ERP ไม่ได้ต้องการข้อความ มันต้องการเลขที่ใบกำกับ วันที่ เลขผู้เสียภาษี ยอดก่อน VAT และรายการสินค้าทีละบรรทัด — แยกเป็นช่อง
ทีมเริ่มเขียน regex ดึงค่า ใช้ได้กับซัพพลายเออร์เจ้าแรก พอเจ้าที่สองเข้ามา ใช้ไม่ได้ เจ้าที่สามยิ่งไม่ได้
เพราะใบแจ้งหนี้ร้อยเจ้าก็ร้อยหน้าตา เจ้าหนึ่งเขียน "ยอดรวมทั้งสิ้น" อีกเจ้าเขียน "Grand Total" บางใบมีทั้งยอดก่อนและหลังหักส่วนลด บางใบเลขที่เอกสารซ่อนอยู่ในตาราง จะเลือกให้ถูกว่าตัวเลขไหนคือยอดที่ต้องลงบัญชี ต้องเข้าใจบริบททั้งใบ ไม่ใช่แค่อ่านตัวอักษรออก
OCR ตอบได้ว่าหน้านี้เขียนว่าอะไร แต่ไม่ได้ตัดสินว่าอะไรคือคำตอบ
งานตัดสินแบบนี้ต้องใช้โมเดลภาษาที่ให้เหตุผลได้ (reasoning model) ทีมจึงออกตามหาโมเดลที่คิดเป็น — และเจอกำแพงถัดไป
สัปดาห์ที่สอง: กำแพง VRAM
โมเดลแบบเปิดที่คิดเป็นมีอยู่จริง แต่ตัวที่เก่งพอจะไว้ใจกับเอกสารการเงิน ล้วนตัวใหญ่ และหน่วยความจำการ์ดจอ (VRAM) ที่ต้องใช้ก็โตตามขนาดทันที
| โมเดล (ตัวอย่าง) | ขนาด | VRAM ความละเอียดเต็ม (BF16) | VRAM แบบบีบอัด 4-bit |
|---|---|---|---|
| Typhoon OCR 1.5 | 3B | ราว 7 GB | ราว 3 GB |
| Qwen2.5-VL 7B | 7B | ราว 17 GB | ราว 6 GB |
| Qwen2.5-VL 32B | 32B | ราว 70 GB | ราว 20 GB |
| Qwen2.5-VL 72B | 72B | ราว 150 GB | ราว 45 GB |
| gpt-oss-120b (อ่านข้อความ ไม่อ่านภาพ) | 120B | — | ราว 80 GB (ตามที่ผู้พัฒนาระบุ) |
การ์ด 12 GB ที่ใช้ทดสอบวันแรกพอสำหรับโมเดล OCR แต่ไม่พอสำหรับโมเดลที่คิดเป็น งานบัญชีจริงมักต้องขยับไปการ์ดระดับ workstation หรือ data center ตั้งแต่ 48 GB ขึ้นไป หรือหลายใบต่อกัน
บีบอัดเป็น 4-bit ก็พอรันได้ แต่ความแม่นลดลงด้วย ต้องวัดกับเอกสารจริงใหม่ทั้งหมด และเมื่อซื้อเครื่องมาแล้ว ยังมีเรื่องไฟ ความร้อน การดูแล และคิวงาน — เอกสารหลายพันหน้าต่อวันบนการ์ดใบเดียว อาจต้องรอกันยาว
โปรเจกต์ที่เริ่มต้นด้วยคำว่า "ฟรี" เริ่มมีใบเสนอราคาฮาร์ดแวร์แนบมาด้วย
เดือนแรก: เอกสารจริงเข้ามา
เอกสารที่ใช้ทดสอบมักเป็นไฟล์ที่สะอาด พอเปิดให้ฝ่ายบัญชีส่งของจริงเข้ามา ปัญหาอีกสามเรื่องโผล่พร้อมกัน
เรื่องแรกคือตาราง ตารางที่มี merge cell ตารางไม่มีเส้น รายการยาวข้ามหน้า ตัวเลขชิดกันจนแยกคอลัมน์ไม่ออก นี่คือจุดที่โมเดลแต่ละตัวทำคะแนนต่างกันมากที่สุด และที่แย่กว่าอ่านผิดคือมันผิดแบบเงียบ ๆ ตัวเลขเลื่อนไปอยู่คอลัมน์ข้าง ๆ หนึ่งช่อง ผลยังดูเป็นตารางที่สมบูรณ์ ไม่มีใครรู้จนกว่ายอดรวมจะไม่ตรง
เรื่องที่สองคือลายเซ็นกับตราประทับ เอกสารจริงมีลายเซ็นทับตัวพิมพ์ ตราประทับเบี้ยวคร่อมยอดเงิน ลายน้ำพาดทั้งหน้า OCR พยายามอ่านทุกอย่างเป็นตัวอักษร บางทีได้ตัวแปลก ๆ ปนมา บางทีข้อความใต้ลายเซ็นหายไปทั้งบรรทัด และถ้าฝ่ายบัญชีถามว่า "ใบนี้เซ็นอนุมัติแล้วหรือยัง" นั่นไม่ใช่คำถามที่ OCR ถูกสร้างมาให้ตอบ
เรื่องที่สามคือชุดเอกสาร ไฟล์สแกนไฟล์เดียวมีใบสั่งซื้อ ใบส่งของ ใบกำกับภาษี และใบเสร็จรวมกันหลายสิบหน้า OCR อ่านทีละหน้า มันไม่รู้ว่าหน้า 3 ถึง 5 คือใบกำกับใบเดียวกัน และไม่รู้ว่าหน้า 6 เป็นเอกสารอะไร การแยกชุด (segmentation) และจัดประเภท (classification) คืออีกระบบที่ต้องสร้างเอง ก่อนจะดึงข้อมูลได้สักช่อง
เดือนที่สอง: "ช่วยเพิ่มอีกช่องได้ไหม"
ระบบเริ่มใช้ได้บางส่วน แล้วคำขอก็เริ่มเข้ามา — ขอเพิ่มเอกสารประเภทใหม่ ขอดึงเลขที่ใบสั่งซื้ออีกช่อง ขอให้ช่องยอดรวมเอาตัวเลขหลังหักส่วนลด ขอส่งข้อมูลไปอีกระบบ
ในระบบที่สร้างเอง ทุกคำขอคือการแก้โค้ด ทดสอบ และ deploy ใหม่ โดยคนที่เขียนระบบเท่านั้น ฝ่ายบัญชีที่เป็นเจ้าของงานจริงต้องเข้าคิวรอทีมพัฒนาทุกครั้งที่ธุรกิจขยับ และถ้าคนเขียนลาออก ระบบก็หยุดโตไปพร้อมกัน
ส่วนทางเลือก fine-tune ให้โมเดลแม่นขึ้น ทำได้ในทางเทคนิค แต่ต้องมีเอกสารที่ติดป้ายคำตอบไว้จำนวนมาก การ์ดจอใหญ่กว่าเครื่องที่ใช้รัน คนที่ทำ machine learning เป็น และต้องวัดผลใหม่ทุกครั้งที่โมเดลรุ่นใหม่ออก สำหรับคำขอแค่ "เอายอดหลังหักส่วนลด" ทางนี้ไกลเกินไปมาก
คำถามที่ไม่มีใครตอบได้: ตัวเลขนี้เชื่อได้ไหม
มาถึงด่านที่สำคัญที่สุด และเป็นด่านที่ทีมส่วนใหญ่ไม่ทันคิดตั้งแต่แรก
ระบบที่สร้างเองแทบทั้งหมดใช้ AI ตัวเดียวอ่านเอกสาร และ AI ตัวเดียวให้คำตอบมาเสมอ ไม่ว่าจะมั่นใจหรือเดา คำตอบที่ถูกกับคำตอบที่เดาผิด หน้าตาเหมือนกันทุกอย่าง
วันที่ผู้จัดการบัญชีถามว่า "ยอดนี้ถูกแน่นะ" ทีมจะเหลือคำตอบแค่สองแบบ — เชื่อทั้งหมดแล้วรับความเสี่ยงว่าตัวเลขผิดจะหลุดเข้าบัญชี หรือให้คนตรวจทุกช่องของทุกใบ ซึ่งกินเวลาไม่ต่างจากคีย์เองตั้งแต่แรก
AI ตัวเดียวไม่มีอะไรให้เทียบ — มันจึงบอกไม่ได้ว่าตัวเองผิดตรงไหน
วิธีที่ทำให้ข้อมูลน่าเชื่อถือ คือให้ AI หลายตัวอ่านเอกสารเดียวกันแยกกัน โดยไม่มีตัวไหนเห็นคำตอบของตัวอื่น ช่องที่ทุกตัวอ่านได้ตรงกันผ่านไปได้ ช่องที่ไม่ตรงกันคือสัญญาณที่ชัดว่าต้องให้คนดู ความเห็นไม่ตรงกันจึงไม่ใช่ข้อเสีย แต่เป็นสิ่งเดียวที่ชี้ได้ว่าความผิดพลาดซ่อนอยู่ตรงไหน
แต่ถ้าจะทำบนเครื่องตัวเอง สามโมเดลหมายถึง VRAM สามเท่าจากตารางข้างบน และถ้าเลือกโมเดลตระกูลเดียวกันหรือฝึกจากข้อมูลคล้ายกัน ก็มักผิดซ้ำที่เดียวกัน การตรวจไขว้จะได้ผลก็ต่อเมื่อ AI แต่ละตัวต่างกันจริง
รวมทุกด่าน: ทำไมโครงการนี้ใช้เวลาเป็นเดือน
การรันโมเดล OCR ให้อ่านเอกสารได้ใช้เวลาเป็นวัน แต่ระบบที่ใช้งานได้จริงต้องมีครบทุกชั้นที่เล่ามา
- รับเอกสารเข้าจากอีเมล โฟลเดอร์ หรือสแกนเนอร์
- แยกชุดและจัดประเภทเอกสาร
- ดึงข้อมูลรายช่องด้วยโมเดลที่เข้าใจบริบท สำหรับเอกสารแต่ละประเภท
- ตรวจความถูกต้อง เช่น ยอดรวมต้องเท่ากับผลรวมบวกภาษี
- ตรวจไขว้ด้วย AI มากกว่าหนึ่งตัว เพื่อรู้ว่าช่องไหนน่าสงสัย
- หน้าจอให้คนตรวจทานและแก้ไข พร้อมบันทึกว่าใครแก้อะไร
- ส่งข้อมูลเข้า ERP หรือระบบบัญชี
- ดูแลต่อเนื่องเมื่อฟอร์มเปลี่ยน โมเดลรุ่นใหม่ออก หรือเครื่องมีปัญหา
แต่ละชั้นคืองานพัฒนาจริงจังของมันเอง ค่าใช้จ่ายก้อนใหญ่ที่สุดจึงไม่ใช่การ์ดจอ แต่เป็นเวลาของคนที่ต้องสร้างและดูแลมันไปตลอด
แล้ว local AI ไม่ดีหรือ
ดี — ถ้าใช้ถูกงาน เอกสารไม่ออกนอกเครื่อง ไม่มีค่าใช้จ่ายต่อหน้า และควบคุมได้ทุกอย่าง
เส้นแบ่งง่าย ๆ คือ local AI เหมาะกับเอกสารที่ไม่ซับซ้อนและหน้าตาตายตัว (fixed template) — ฟอร์มเดิม ช่องเดิม ตำแหน่งเดิมทุกใบ เพราะเมื่อหน้าตาไม่เปลี่ยน ก็ไม่ต้องใช้โมเดลที่คิดเป็น เขียนกฎดึงค่าครั้งเดียวใช้ได้ยาว
| เหมาะกับ local AI | ไม่เหมาะกับ local AI | |
|---|---|---|
| ลักษณะเอกสาร | ฟอร์มเดียว หน้าตาตายตัว ไม่ค่อยเปลี่ยน | หน้าตาหลากหลาย เปลี่ยนตามผู้ส่ง ต้องตีความบริบท |
| ตัวอย่าง | ใบลา ใบเบิกค่าใช้จ่าย หรือใบขออนุมัติที่บริษัทออกแบบเอง · ใบรับสินค้าหรือ checklist ตรวจงานที่พิมพ์จากระบบของตัวเอง · ใบเสร็จจากเครื่อง POS ระบบเดียว | ใบแจ้งหนี้และใบกำกับภาษีจากซัพพลายเออร์หลายเจ้า · สัญญาที่ต้องหาเงื่อนไขในเนื้อความ · เอกสารที่มีตารางซับซ้อน · หนังสือราชการ |
| สิ่งที่ต้องการจากระบบ | อ่านข้อความออก แล้วดึงค่าจากตำแหน่งเดิม | เข้าใจว่าค่าไหนคือคำตอบ ตรวจไขว้ และรู้ว่าช่องไหนต้องให้คนดู |
งานอื่นที่เริ่มจาก local OCR ได้เลย
- ทำ RAG หรือระบบค้นหาเอกสาร ที่ต้องการข้อความทั้งหน้า ไม่ต้องแยกช่อง
- แปลงเอกสารเก่าเป็นข้อความเพื่อเก็บถาวร
- ทีมมีคนทำ machine learning และพร้อมดูแลระบบเองระยะยาว
- ข้อกำหนดด้านข้อมูลไม่อนุญาตให้ใช้บริการภายนอกเลย
แต่ถ้างานของคุณอยู่ในคอลัมน์ขวา — ใบแจ้งหนี้จากหลายเจ้า สัญญา ตารางซับซ้อน หรือหนังสือราชการ — ทุกด่านที่เล่ามาข้างบนจะเกิดขึ้นครบ และ local AI ไม่ใช่ทางที่คุ้ม
และไม่ว่าจะเลือกตัวไหน ทดสอบหลายตัวกับเอกสารของคุณเอง ตัวที่ชนะบนเอกสารคนอื่น อาจไม่ชนะบนเอกสารคุณ
ถ้าปลายทางคือข้อมูลเข้าระบบ
ทุกด่านที่เล่ามาเกิดขึ้นหลังการอ่าน และนั่นคือส่วนที่ LuminexDoc ถูกสร้างมาเพื่อทำ
- AI สามตัวจากคนละค่ายอ่านทุกช่องแยกกัน ช่องที่ตรงกันผ่านได้ ช่องที่ไม่ตรงกันเท่านั้นที่ถึงมือคน
- ใช้ AI ที่เข้าใจบริบทของเอกสาร เลือกค่าที่ถูกได้แม้ซัพพลายเออร์แต่ละเจ้าวางฟอร์มต่างกัน โดยไม่ต้องลงทุนฮาร์ดแวร์เอง
- แยกชุดเอกสารและจัดประเภทให้อัตโนมัติ ก่อนเริ่มดึงข้อมูล
- ดึงข้อมูลเป็นรายช่องตามที่กำหนด สั่งด้วยภาษาคน ไม่ต้องสร้างเทมเพลต
- ตรวจได้ว่าเอกสารมีลายเซ็นหรือตราประทับแล้วหรือยัง
- คลิกช่องไหน ระบบตีกรอบตรงนั้นบนภาพเอกสารจริง ตรวจได้เร็ว
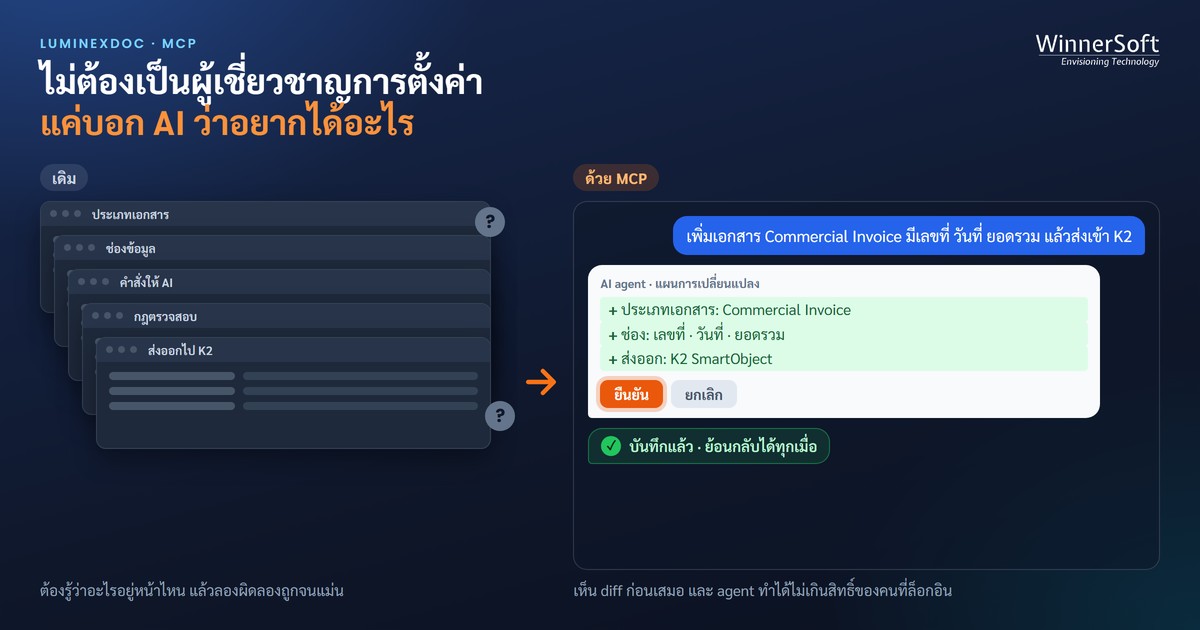
- ปรับตั้งค่าเองได้ทั้งประเภทเอกสาร ช่องข้อมูล กฎตรวจ และปลายทาง โดยไม่ต้องแก้โค้ด และสั่งงานผ่าน AI agent ด้วย MCP ได้
- จับคู่ข้อมูลข้ามเอกสาร และส่งเข้า ERP, SQL Server หรือ K2 ได้โดยตรง
- ติดตั้งแบบ on-premises ได้ สำหรับองค์กรที่มีข้อกำหนดด้านข้อมูล
local OCR ตอบคำถามว่า "หน้านี้เขียนว่าอะไร" ส่วนงานเอกสารขององค์กรต้องการคำตอบว่า "ช่องนี้คือค่าอะไร ถูกหรือเปล่า และควรไปลงตรงไหน" — สองคำถามนี้ห่างกันไกลกว่าที่เห็นในวันแรก
ก่อนตัดสินใจทางไหน ลองเอาเอกสารจริงของคุณมาทดสอบเทียบกันดู ติดต่อเราเพื่อนัดทดสอบกับ LuminexDoc ได้