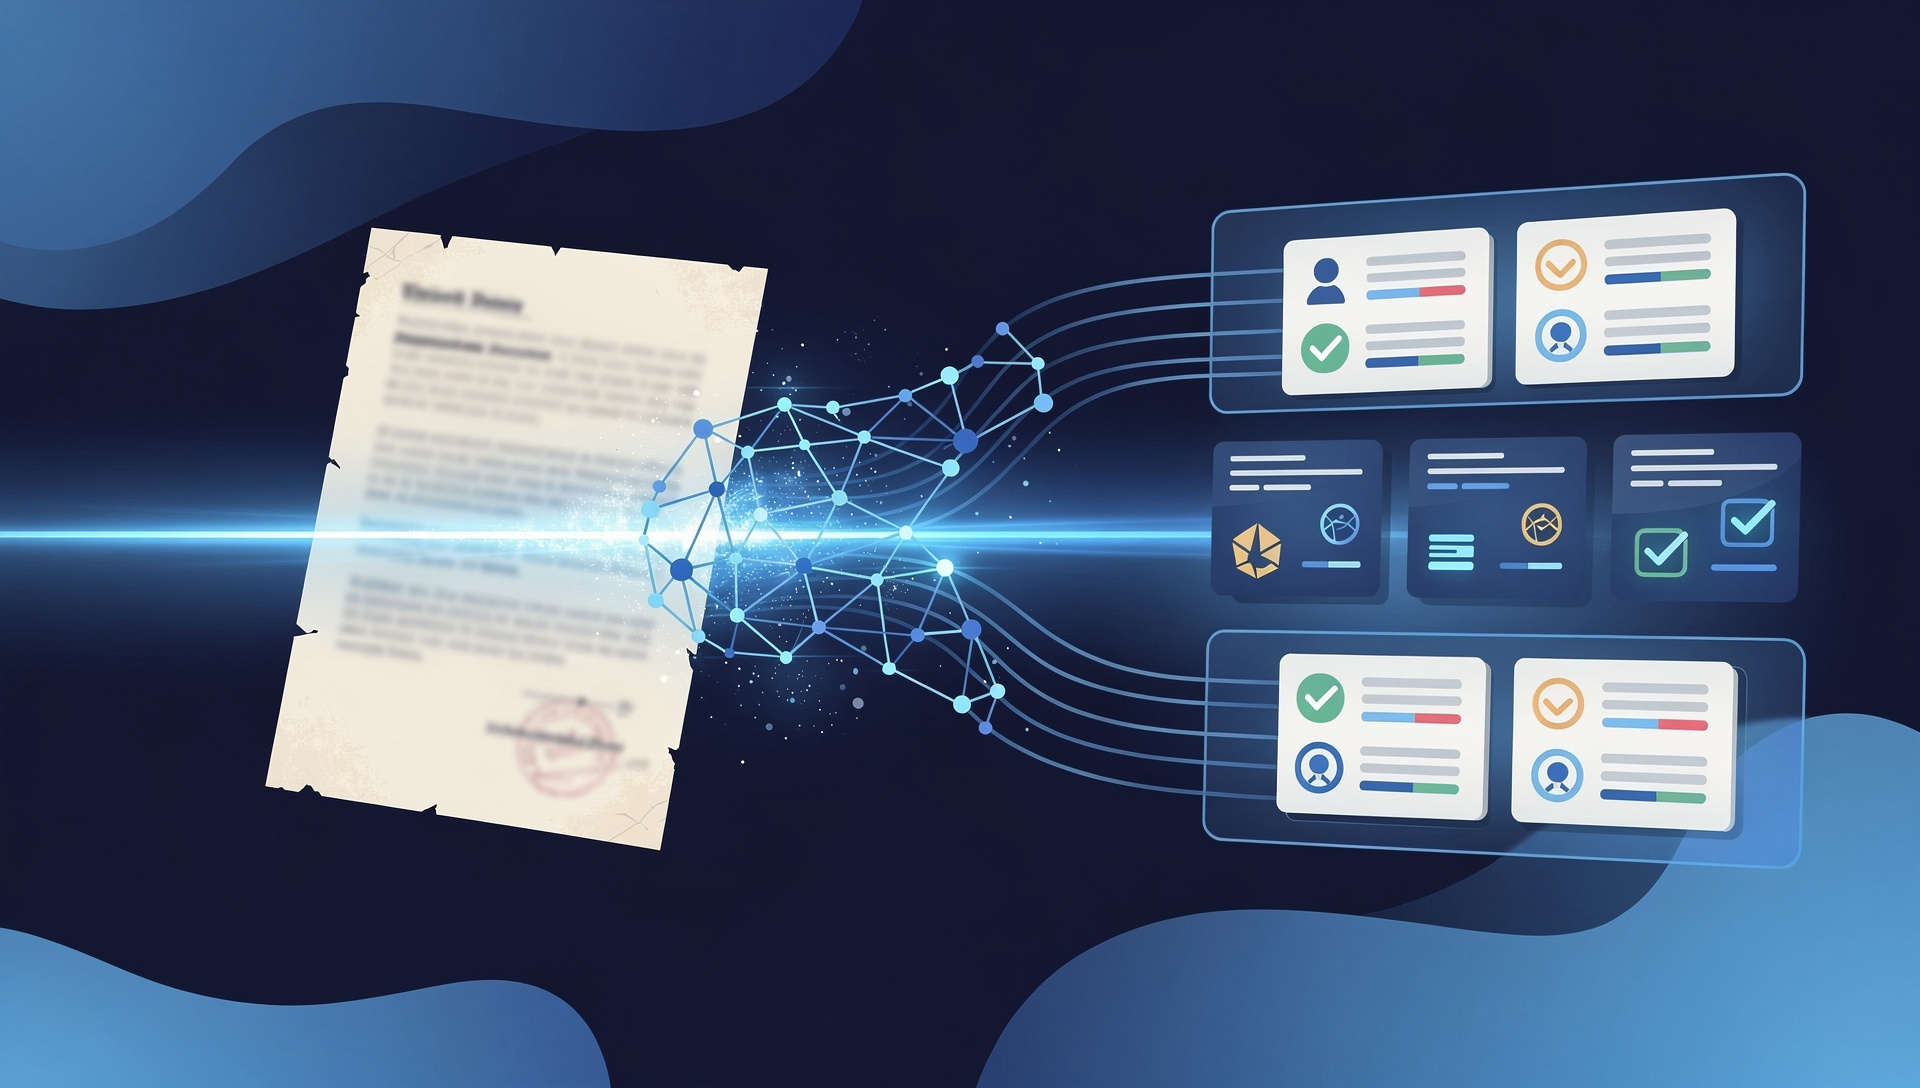
OCR แบบดั้งเดิม (Optical Character Recognition) อ่านข้อความจากหน้าเอกสารที่สแกนมานานหลายสิบปี — แต่ลำพังตัวมันเองหยุดอยู่แค่การแปลงภาพเป็นตัวอักษร ส่วน AI-powered OCR คือเจเนอเรชันถัดไป: มันคงความสามารถของ OCR ในการอ่านข้อความ แล้วเสริมปัญญาประดิษฐ์ไว้บนนั้นเพื่อเข้าใจว่าเอกสารหมายถึงอะไร ตรวจสอบความถูกต้องของข้อมูล และป้อนเข้าระบบธุรกิจโดยตรง ผลลัพธ์ไม่ใช่การพัฒนาทีละนิด แต่เป็นการก้าวกระโดด ในขณะที่ OCR ธรรมดาให้ข้อความที่ไม่มีโครงสร้างเป็นกำแพงที่ยังต้องมีคนตรวจ AI-powered OCR ให้ข้อมูลที่สะอาด มีโครงสร้าง พร้อมใช้งานทันที และบอกได้ว่าฟิลด์ไหนที่ยังไม่แน่ใจ สำหรับองค์กรไทยที่จมอยู่กับใบแจ้งหนี้ สัญญา แบบฟอร์ม KYC และเอกสารราชการ ความต่างนี้คือเส้นแบ่งระหว่างกระบวนการเอกสารที่ยังต้องใช้พนักงานคีย์ข้อมูลจำนวนมาก กับกระบวนการที่แทบทำงานได้ด้วยตัวเอง
แล้ว 'AI' เพิ่มอะไรเข้าไปกันแน่ และทำไมจึงสำคัญต่อเอกสารที่องค์กรของคุณจัดการทุกวัน? บทความนี้จะแยกย่อยการพัฒนาที่เฉพาะเจาะจง — ความแม่นยำ การปรับตัว ความเข้าใจภาษา การตรวจสอบ และระบบอัตโนมัติครบวงจร — และแสดงให้เห็นว่าแพลตฟอร์มอย่าง LuminexDoc นำสิ่งเหล่านี้ไปใช้กับเอกสารธุรกิจไทยจริงๆ อย่างไร
ระบบ OCR อ่านเอกสารอัตโนมัติ ประกอบด้วยอะไรบ้าง
คำว่าอ่านเอกสารอัตโนมัติครอบคลุมสี่ขั้นตอนที่ต้องต่อกันได้ ไม่ใช่ขั้นตอนเดียว — รับเอกสารเข้ามาจากเมล โฟลเดอร์ หรือเครื่องสแกน, อ่านตัวอักษรออกจากภาพ, ตีความว่าตัวอักษรแต่ละก้อนคือฟิลด์อะไร, แล้วส่งผลลัพธ์ออกไปยังระบบปลายทาง
ระบบที่ทำได้แค่ขั้นที่สองคือ OCR เฉย ๆ ส่วนระบบที่เดินครบทั้งสี่ขั้นโดยคนไม่ต้องแตะระหว่างทาง คือสิ่งที่คนเรียกกันว่าอ่านเอกสารอัตโนมัติจริง ๆ เวลาเทียบผู้ขาย ให้ถามว่าเขาทำครบกี่ขั้น ไม่ใช่ถามว่าอ่านแม่นกี่เปอร์เซ็นต์
1. ความแม่นยำสูงขึ้นอย่างมากกับเอกสารในโลกจริง
OCR ธรรมดาทำงานได้ดีกับข้อความพิมพ์ที่สะอาดและจัดเรียงตรงสมบูรณ์ — แต่เอกสารธุรกิจจริงแทบไม่เคยเรียบร้อยขนาดนั้น มันคือเอกสารสแกนเอียง รูปถ่ายจากมือถือ ใบเสร็จกระดาษความร้อนที่ซีดจาง ตราประทับทับตัวเลข และลายมือตามขอบกระดาษ กับเอกสารแบบนี้ ความแม่นยำของ OCR ดั้งเดิมตกลงอย่างรวดเร็ว และที่แย่กว่านั้นคือมันส่งค่าผิดออกมาเงียบๆ — อ่าน '8' อย่างมั่นใจทั้งที่เลขจริงคือ '6' AI-powered OCR ใช้โมเดล machine learning ที่ฝึกจากเอกสารจริงหลายล้านฉบับเพื่อตีความข้อความที่เสื่อมคุณภาพและกำกวมตามบริบท อ่านเอกสารเหล่านี้ได้ถูกต้องมากขึ้นอย่างชัดเจน และที่สำคัญไม่แพ้กันคือมันรู้ว่าเมื่อใดที่ไม่แน่ใจ: แทนที่จะเดา มันให้คะแนนความมั่นใจและคัดฟิลด์ที่ความมั่นใจต่ำให้คนตรวจอย่างรวดเร็ว ข้อผิดพลาดจึงถูกจับได้แทนที่จะถูกลงบัญชี
2. เข้าใจความหมาย ไม่ใช่แค่ตัวอักษร
นี่คือการก้าวกระโดดหลัก OCR ให้คุณได้ข้อความเรียงต่อกัน แต่ AI-powered OCR ให้ข้อมูลที่มีโครงสร้างพร้อมความหมายกำกับ ด้วย natural language processing มันรู้ว่า 'ยอดรวมทั้งสิ้น', 'Grand Total' และ 'Total Amount Due' ล้วนชี้ไปที่ฟิลด์เดียวกัน ไม่ว่าจะอยู่ตรงไหนของหน้าหรือผู้ขายรายใดส่งมา มันแยกที่อยู่สำหรับวางบิลออกจากที่อยู่จัดส่ง เชื่อมเลขผู้เสียภาษีกับผู้ขายที่ถูกต้อง และระบุได้ว่าวันที่หนึ่งเป็นวันที่ใบแจ้งหนี้ ไม่ใช่วันครบกำหนด แทนที่จะยื่นกองข้อความให้คนตีความ AI-powered OCR ส่งมอบฟิลด์ที่มีป้ายกำกับและผ่านการตรวจสอบแล้ว — ผู้ขาย เลขที่ใบแจ้งหนี้ รายการสินค้า VAT ยอดรวม — พร้อมใช้งานทันที
3. ไม่ต้องสร้างเทมเพลตให้ทุกเลย์เอาต์อีกต่อไป
การดึงข้อมูลของ OCR ดั้งเดิมขึ้นอยู่กับเทมเพลตที่ตายตัว: คุณต้องบอกระบบว่า 'เลขที่ใบแจ้งหนี้อยู่ในกรอบนี้' พอผู้ขายเปลี่ยนเลย์เอาต์ — หรือผู้ขายรายใหม่ส่งรูปแบบที่คุณไม่เคยเห็น — เทมเพลตก็พังและการประมวลผลหยุดชะงักจนกว่าจะมีคนสร้างใหม่ AI-powered OCR ไม่ต้องใช้เทมเพลต เพราะมันรู้จำฟิลด์จากบริบทและรูปแบบแทนตำแหน่งตายตัว จึงประมวลผลใบแจ้งหนี้รูปแบบใหม่ได้ถูกต้องตั้งแต่ครั้งแรก สำหรับบริษัทที่รับเอกสารจากแหล่งนับสิบหรือนับร้อยราย สิ่งนี้กำจัดงานบำรุงรักษาที่ต้องทำต่อเนื่องทั้งหมวด และทำให้ระบบอัตโนมัติไม่ตามรายชื่อผู้ขายที่เพิ่มขึ้นไม่ทัน
4. ความเข้าใจภาษาไทยอย่างแท้จริง
เครื่องมือ OCR ระดับโลกส่วนใหญ่สร้างมาเพื่ออักษรละตินและมองภาษาไทยเป็นเรื่องรอง ภาษาไทยยากสำหรับเครื่องจริงๆ: ไม่มีการเว้นวรรคระหว่างคำ สระและวรรณยุกต์ซ้อนกันทั้งด้านบนและล่างของบรรทัดพยัญชนะ และเอกสารธุรกิจปนไทย-อังกฤษในบรรทัดเดียวกันตลอด OCR พื้นฐานทำส่วนนี้พัง AI-powered OCR ที่ฝึกด้วยภาษาไทยเข้าใจคำประสม แยกที่อยู่ไทยเป็นจังหวัด/อำเภอ/ตำบล/รหัสไปรษณีย์ อ่านวันที่แบบ พ.ศ. และแปลงได้ถูกต้อง และจัดการเอกสารสองภาษาโดยไม่เสียความแม่นยำ สำหรับองค์กรไทย นี่คือความต่างระหว่างเครื่องมือที่เดโมสวยกับตัวอย่างภาษาอังกฤษ กับเครื่องมือที่ใช้งานได้จริงกับเอกสารจริงของคุณ
5. การตรวจสอบในตัวและ Multi-AI Consensus
โมเดล AI เดี่ยวก็ยังพลาดได้ แพลตฟอร์ม AI-powered OCR ที่แข็งแกร่งที่สุดจะรันหลายโมเดลกับเอกสารเดียวกันแล้วเปรียบเทียบผลลัพธ์ — แนวทางแบบ consensus เมื่อทุกโมเดลเห็นตรงกันในค่าหนึ่ง ความมั่นใจสูงและรับค่านั้นอัตโนมัติ เมื่อไม่ตรงกัน ความต่างจะถูกคัดออกมาให้ตรวจสอบ การยืนยันแบบ 3-way AI นี้ลดปัญหาข้อผิดพลาดเงียบที่รุมเร้า OCR ดั้งเดิมได้อย่างมาก เมื่อรวมกับการตรวจตามกฎธุรกิจ — รายการสินค้ารวมแล้วได้ยอดรวมหรือไม่ VAT คำนวณถูกไหม ใบแจ้งหนี้ตรงกับใบสั่งซื้อหรือเปล่า — การตรวจสอบหมายความว่ามีเพียงกรณีที่กำกวมจริงๆ (โดยทั่วไปต่ำกว่า 5%) เท่านั้นที่ถึงมือคน ส่วนที่เหลือไหลผ่านตรง
6. ระบบอัตโนมัติครบวงจร ไม่ใช่แค่การดึงข้อมูล
การพัฒนาที่ใหญ่ที่สุดคือสิ่งที่เกิดขึ้นหลังจากอ่านเอกสาร OCR ธรรมดาส่งผลลัพธ์กลับให้คนที่ยังต้องคีย์ข้อมูลไปที่ไหนสักแห่ง AI-powered OCR ปิดวงจร: ข้อมูลที่ผ่านการตรวจสอบถูกเขียนเข้าระบบบัญชี ERP หรือระบบ compliance โดยตรงผ่านคอนเนกเตอร์และ API การอนุมัติถูกส่งต่ออัตโนมัติ และเอกสารต้นฉบับถูกแนบไว้เพื่อการตรวจสอบ ใบแจ้งหนี้ผู้ขายเข้ามาทางอีเมลและปรากฏเป็นรายการที่จับคู่และลงบัญชีแล้วในสมุดบัญชีของคุณภายในไม่กี่นาที โดยมีคนเข้ามาเกี่ยวข้องเฉพาะกรณียกเว้น นี่คือสิ่งที่เปลี่ยนการประมวลผลเอกสารจากศูนย์ต้นทุนที่ใช้ทีมคีย์ข้อมูล ไปเป็นไปป์ไลน์อัตโนมัติที่ขยายตามปริมาณงานแทนที่จะขยายตามจำนวนพนักงาน
ผลตอบแทนที่วัดได้
- ความเร็ว: เวลาประมวลผลต่อเอกสารลดจาก 15-20 นาทีของการจัดการด้วยมือ เหลือไม่ถึง 30 วินาทีของกระบวนการที่เป็นอัตโนมัติเป็นส่วนใหญ่
- ความแม่นยำ: AI-powered OCR อ่านเอกสารสแกนเอียง รูปถ่าย และลายมือที่ OCR ธรรมดาอ่านผิดได้ และคัดฟิลด์ที่ไม่แน่ใจให้คนตรวจ
- ต้นทุนข้อผิดพลาดต่ำลง: การดึงข้อมูลที่ผ่านการตรวจสอบกำจัดความผิดพลาดที่มีราคาแพง — เลขสลับตำแหน่ง ผู้ขายผิด ยอดภาษีคีย์ผิด — ที่ OCR ธรรมดาปล่อยผ่านเงียบๆ
- แรงงานมือลดลง: พนักงานขยับจากการคีย์ซ้ำๆ ไปสู่การจัดการกรณียกเว้นและการวิเคราะห์ และทีมไม่ต้องโตเป็นเส้นตรงตามปริมาณเอกสาร
- ปิดบัญชีเร็วขึ้นและ compliance ดีขึ้น: ร่องรอยการตรวจสอบที่ครบถ้วนของทุกการดึงข้อมูลและการแก้ไขช่วยเร่งการปิดบัญชีสิ้นเดือนและรองรับข้อกำหนด PDPA
OCR ธรรมดาอ่านเอกสารของคุณ AI-powered OCR เข้าใจมัน ตรวจงานตัวเอง และทำงานให้จบ — เปลี่ยนภาพเป็นข้อมูลที่เชื่อถือได้โดยไม่ต้องมีคนอยู่ในวงจรสำหรับงานส่วนใหญ่
LuminexDoc นำ AI-Powered OCR ไปใช้อย่างไร
LuminexDoc โดย WinnerSoft ถูกสร้างขึ้นรอบแนวทางนี้พอดี มันใช้ OCR เป็นชั้นอ่านตัวอักษร แล้วใช้ AI เข้าใจเอกสารแต่ละฉบับ ดึงฟิลด์ที่คุณต้องการโดยไม่ต้องมีเทมเพลตต่อผู้ขาย และตรวจสอบความถูกต้องผ่านการยืนยันแบบ 3-way AI consensus ที่คัดเฉพาะค่าที่ไม่แน่ใจจริงๆ มันถูกสร้างมาเพื่อองค์กรไทยโดยเฉพาะ — ด้วยความเข้าใจภาษาไทยแบบเนทีฟ รองรับวันที่แบบ พ.ศ. รองรับเอกสารสองภาษา และตัวเลือกการติดตั้งที่ยืดหยุ่นรวมถึงแบบ on-premises สำหรับองค์กรที่มีกฎด้านการเก็บข้อมูลในประเทศอย่างเข้มงวด และมันเชื่อมต่อโดยตรงกับระบบบัญชีและ ERP เพื่อให้ข้อมูลไม่ใช่แค่ถูกอ่าน — แต่ถูกนำไปใช้ หากต้องการเห็นการพัฒนาบนเอกสารของคุณเองแทนตัวเลขมาตรฐานทั่วไป เชิญเยี่ยมชมหน้า LuminexDoc ที่ /luminexdoc หรือติดต่อทีมงานของเราที่ /contact เพื่อรับการประเมินการประมวลผลเอกสารฟรี